Samenvatting
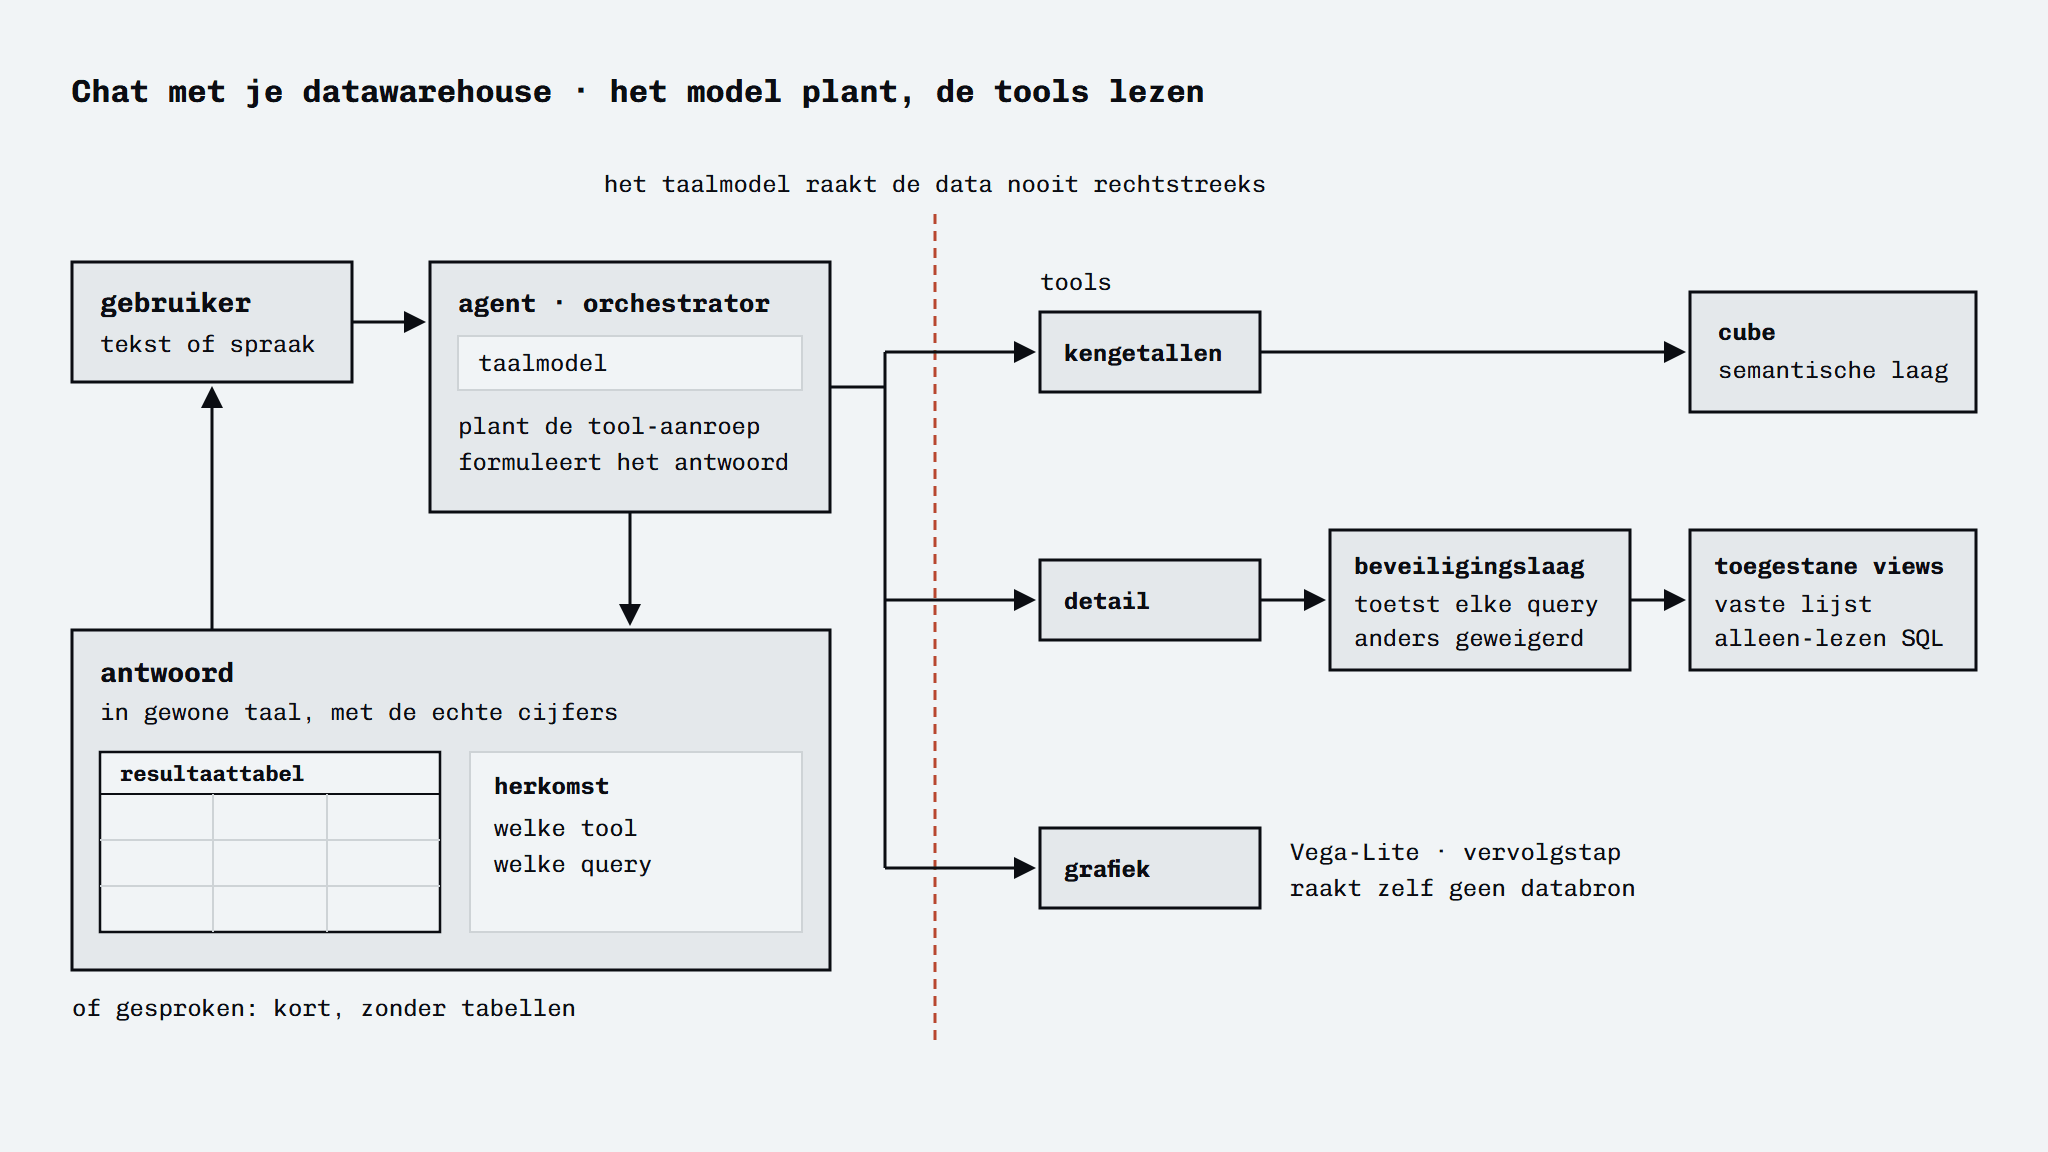
Een agent waarmee medewerkers in gewone taal vragen kunnen stellen aan het datawarehouse, als aanvulling op de bestaande Power BI-rapportages, niet als vervanging. De agent zet een vraag om in een geplande tool-aanroep, laat een aparte beveiligingslaag de query uitvoeren, en formuleert het antwoord met de echte cijfers erbij. Op verzoek tekent hij het resultaat als grafiek, en via een spraaklaag kan een vraag ook worden ingesproken, met een kort gesproken antwoord terug. Het systeem is opgebouwd als modular monolith: één applicatie, intern verdeeld in losse, per omgeving aan of uit te zetten modules met een vaste interface. De kern die de scope bewaakt, een lijst met toegestane bronnen en velden, wordt los onderhouden als het belangrijkste stuk kennis in het systeem.
De vraag
Onderzoeken of medewerkers via natuurlijke taal vragen kunnen stellen over data uit het datawarehouse, zonder dat het taalmodel ooit rechtstreeks toegang krijgt tot het datawarehouse of tot niet-toegestane informatie.
Wat ik heb gebouwd
- Een orchestrator die een vraag plant, de juiste tool aanroept en het resultaat terugkoppelt
- Een tool die kengetallen ophaalt door natuurlijke taal om te zetten naar een query op een semantische laag (cube)
- Een tool die detailgegevens ophaalt via een beveiligde, alleen-lezen SQL-laag op een vaste lijst toegestane views
- Een beveiligingslaag die elke query controleert en alleen leesopdrachten op die toegestane views doorlaat
- Een uitbreidbare module-registry waarmee onderdelen per omgeving aan of uit te zetten zijn
- Een lichte chat-interface die naast het antwoord ook de resultaattabel en de herkomst toont (welke tool, welke query)
- Een grafiek-tool die het resultaat van de laatste geslaagde query als Vega-Lite-grafiek in het antwoord tekent (staaf, lijn, punt of vlak); het taalmodel kiest alleen de weergave, de getallen komen rechtstreeks uit de query en gaan niet door het model heen
- Een spraaklaag op dezelfde chat-interface: inspreken na een wake word, onderbreken met een stopcommando, en een apart kort antwoord in spreektaal zonder tabellen of lange cijferreeksen
In detail
- Twee databronnen, één ingang: kengetallen uit de semantische cube-laag (dezelfde cijfers als in Power BI), detailgegevens via een streng afgebakende SQL-route; de agent kiest zelf welke route past
- Beveiligingslaag tussen taalmodel en data: elke gegenereerde query wordt gevalideerd, alleen leesopdrachten op een goedgekeurde lijst komen erdoorheen, dus het taalmodel kan nooit niet-vrijgegeven data opvragen
- Herkomst bij elk antwoord: naast het antwoord in proza toont de interface de resultaattabel en welke tool en query het hebben opgeleverd
- Uitbreidbare module-opzet: een nieuwe capaciteit wordt als zelfstandige module toegevoegd, per omgeving aan of uit te zetten, zonder de kernlogica aan te raken
- Weigeren buiten scope: vragen die buiten de toegestane bronnen vallen worden herkend en afgewezen in plaats van verzonnen beantwoord
- Grafiek of gesproken antwoord op verzoek: de grafiek tekent exact de rijen uit de laatste geslaagde query, niet wat het taalmodel doorgeeft, en de spraaklaag voorkomt dat de assistent zijn eigen voorgelezen antwoord oppikt als nieuwe vraag
Resultaat
Werkt end-to-end, met de kengetallen rechtstreeks uit de productie-cube, en is gedekt door circa 180 Python-tests en 13 JavaScript-tests. Drie onderdelen stonden bij de laatste stand nog open: een documentzoekfunctie (de onderliggende zoekinfrastructuur stond tijdelijk uit), een alternatieve REST-aansluiting op de cube-laag die nog tegen een echte dataset geverifieerd moest worden, en de spraakherkenning, die via de browser liep (Chrome en Edge) en voor productiegebruik naar Azure Speech in de EU-regio moest.